Durante los últimos meses, los propietarios de sitios web se han enfrentado a una pregunta cada vez más importante: ¿debo permitir que los bots de inteligencia artificial utilicen el contenido de mi página?
El problema es que bloquear determinados crawlers podía tener una consecuencia no deseada: algunos bots tienen más de una función y pueden utilizarse tanto para indexar páginas en buscadores como para otros usos relacionados con inteligencia artificial.
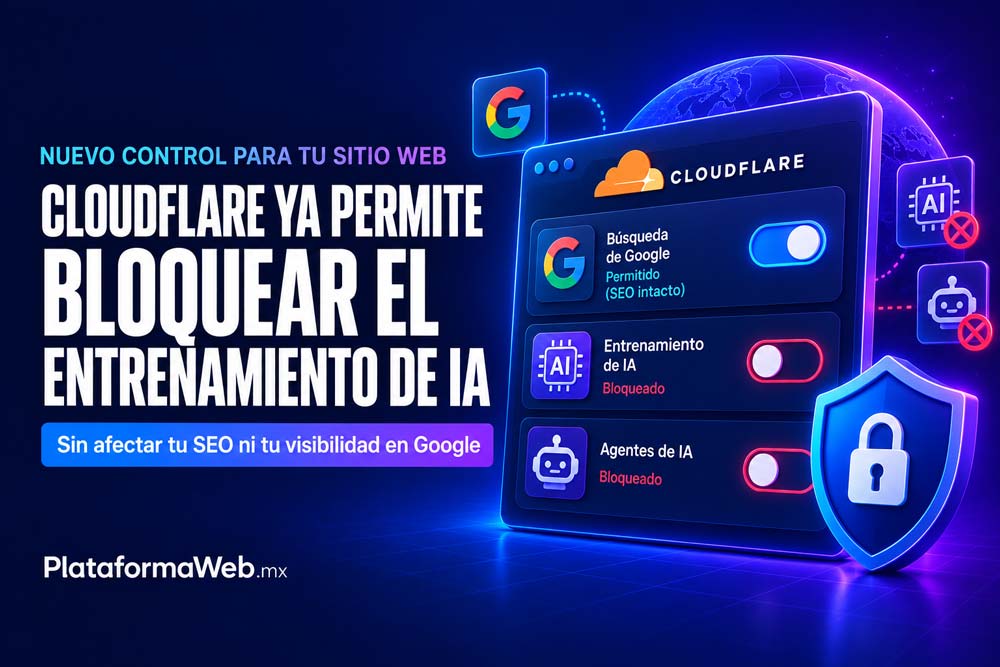
Cloudflare acaba de introducir una solución mucho más precisa. Desde el 15 de septiembre de 2026, sus controles permiten diferenciar entre bots utilizados para búsqueda, entrenamiento de modelos de IA y agentes de IA. Además, existe una nueva opción denominada Disallow AI Training, diseñada para impedir el entrenamiento sin sacrificar la visibilidad tradicional en buscadores.
¿Qué cambió en Cloudflare?
Hasta ahora, muchos propietarios de sitios veían simplemente una opción similar a Block AI Bots. Cloudflare está sustituyendo ese enfoque general por controles separados según la finalidad del crawler.
Search
Bots que rastrean e indexan contenido para que pueda encontrarse posteriormente en búsquedas.
Training
Bots que recopilan contenido para entrenar o ajustar modelos de inteligencia artificial.
Agent
Agentes que acceden a una página en tiempo real para realizar una acción en nombre de un usuario.
Esta separación es importante porque no todo el tráfico automatizado tiene el mismo propósito. Para una empresa normalmente tiene sentido que Google pueda rastrear su página para mostrarla cuando alguien busca sus servicios. Eso no significa necesariamente que esa misma empresa quiera permitir que todo su contenido se utilice para entrenar modelos de IA.
El riesgo: bloquear Googlebot sin darte cuenta
A partir del cambio de septiembre, las opciones Block y Block on pages with ads pueden afectar también a crawlers de uso mixto como Googlebot, Bingbot y Applebot. Por lo tanto, elegir simplemente Block dentro de los controles de Training puede tener consecuencias diferentes de las que esperabas.
Cloudflare lo explica de forma explícita: para impedir el entrenamiento pero mantener el rastreo de búsqueda, la opción adecuada es Disallow AI Training.
Quieres aparecer en Google y no quieres entrenamiento de IA → Disallow AI Training.
Quieres impedir completamente el acceso del crawler → Block.
Para la mayoría de sitios corporativos, tiendas online, blogs y páginas de servicios, bloquear accidentalmente los crawlers utilizados para búsqueda sería una decisión mucho más seria.
¿Disallow AI Training afecta el posicionamiento en Google?
La nueva configuración busca precisamente separar ambas finalidades. Cloudflare indica que la opción Disallow AI Training permite que los rastreadores de uso mixto responsables sigan accediendo para búsqueda mientras se publica la preferencia de no utilizar el contenido para entrenamiento.
Cloudflare utiliza además Bot Preference Sync para mantener sincronizadas determinadas preferencias con el archivo robots.txt. Esto evita tener que mantener manualmente diferentes reglas cada vez que cambia un crawler.
Google, OpenAI, Anthropic y otros no utilizan exactamente los mismos bots
Las compañías de IA no gestionan el rastreo de la misma manera. Cloudflare identifica a Google, Apple y Microsoft como operadores de crawlers de uso mixto que respetan o se han comprometido a respetar estas preferencias. Otras empresas, entre ellas OpenAI, Anthropic, Meta y Amazon, utilizan crawlers diferenciados para determinados usos.
Eso permite bloquear específicamente los destinados a entrenamiento sin necesariamente impedir otros tipos de acceso.
Esta distinción será cada vez más importante conforme los agentes de IA comiencen a visitar sitios directamente para buscar productos, comparar servicios o realizar acciones en nombre de los usuarios.
¿Qué configuración conviene para una página empresarial?
No existe una configuración perfecta para todos los sitios. Para una página corporativa cuyo objetivo principal es conseguir clientes desde Google, una estrategia razonable puede ser la siguiente.
Mantener Search permitido
Los buscadores necesitan rastrear las páginas para indexarlas y mantener actualizada su información. Bloquear Search sin una razón concreta puede perjudicar directamente la capacidad del sitio para aparecer en buscadores.
Decidir por separado sobre Training
Si la empresa no desea que su contenido sea utilizado para entrenamiento de modelos, puede utilizar Disallow AI Training. Esto es especialmente interesante para sitios que publican contenido original, investigaciones, documentación, cursos, fotografías, artículos especializados o grandes cantidades de información propia.
Evaluar Agent según el tipo de negocio
Los agentes representan un caso diferente. Un futuro cliente podría pedirle a un asistente: “Encuentra tres proveedores de este servicio en Monterrey y compara precios”.
En ese escenario, permitir que un agente consulte correctamente tu sitio podría convertirse en una nueva fuente de descubrimiento comercial. Por eso no recomendamos bloquear automáticamente todos los agentes sin analizar primero el objetivo del sitio.
¿Y si mi página tiene publicidad?
Cloudflare está prestando especial atención a los sitios financiados mediante publicidad. Para nuevos dominios con páginas que muestran anuncios, sus configuraciones recomendadas pueden permitir Search, restringir el entrenamiento y limitar agentes en páginas con publicidad.
La lógica es sencilla: si el modelo de negocio depende de que una persona visite la página y vea publicidad, un bot que consume el contenido sin generar esa visita puede alterar la economía del sitio.
Para una página empresarial cuyo objetivo es generar prospectos, la decisión puede ser diferente: que un agente encuentre y recomiende el negocio podría resultar beneficioso.
Cómo revisar la configuración en Cloudflare
Si tu dominio utiliza Cloudflare, conviene revisar el panel en lugar de asumir que la configuración anterior continúa haciendo exactamente lo mismo.
Cloudflare documenta actualmente estos controles dentro de Security → Settings → Configure AI bot policies.
Revisa especialmente las configuraciones correspondientes a:
- Search
- Training
- Agent
Si tu objetivo es mantener la indexación tradicional y rechazar específicamente el entrenamiento, busca Disallow AI Training en lugar de utilizar un bloqueo general.
¿Esto reemplaza robots.txt?
No exactamente. Cloudflare está migrando su anterior función Managed Robots.txt hacia Bot Preference Sync, que permite reflejar automáticamente determinadas preferencias en robots.txt y mantenerlas sincronizadas con las reglas configuradas en la plataforma.
Pero existe otra diferencia importante: robots.txt expresa una preferencia a un crawler; Cloudflare también dispone de infraestructura en la red capaz de identificar y bloquear tráfico.
Esto resulta especialmente relevante frente a bots que no respetan voluntariamente las instrucciones publicadas por el sitio.
La IA está cambiando lo que significa “ser visible” en Internet
Durante años, la estrategia era relativamente sencilla:
Google rastrea → Google indexa → usuario busca → usuario visita tu sitio.
Ahora aparecen más escenarios:
IA rastrea → IA aprende
IA consulta → IA responde
agente consulta → agente recomienda
agente consulta → agente realiza una acción
Para las empresas, la decisión ya no debería ser simplemente “permitir o bloquear bots”. La pregunta correcta empieza a ser: ¿para qué permito que cada tipo de bot utilice mi contenido?
Qué recomendamos revisar en 2026
- Que Search continúe permitido si dependes del posicionamiento orgánico.
- Que la política de Training corresponda realmente con lo que quieres permitir.
- Que no hayas heredado una configuración antigua de “Block AI Bots” sin revisar cómo fue migrada a los nuevos controles.
No recomendamos bloquear indiscriminadamente todos los bots relacionados con inteligencia artificial. La búsqueda tradicional, los buscadores con IA y los agentes están empezando a mezclarse. La mejor estrategia será mantener el sitio accesible para los canales que puedan generar descubrimiento y clientes, mientras conservas control sobre otros usos de tu contenido.
Preguntas frecuentes
¿Puedo bloquear el entrenamiento de IA sin desaparecer de Google?
Sí. Cloudflare introdujo Disallow AI Training precisamente para separar el uso de contenido para entrenamiento de la función de búsqueda.
¿Debo bloquear todos los bots de IA?
No necesariamente. Un crawler de entrenamiento y un agente que busca información para un usuario tienen propósitos diferentes. Para un negocio, algunos agentes podrían convertirse en una futura fuente de clientes.
¿Esto también aplica a WordPress?
Sí. El control funciona a nivel de Cloudflare, por lo que puede utilizarse independientemente de que el sitio esté desarrollado con WordPress, WooCommerce u otra plataforma.
¿Necesito modificar manualmente robots.txt?
No siempre. Bot Preference Sync puede reflejar determinadas preferencias configuradas en Cloudflare y conservar las instrucciones existentes del archivo robots.txt del sitio.
Protege tu contenido sin perder visibilidad
El cambio de Cloudflare parece pequeño —unas nuevas opciones dentro del panel—, pero refleja una transformación mucho mayor de Internet.
Ya no basta con decidir si permitimos que “los bots” entren al sitio. Necesitamos distinguir buscadores, sistemas de entrenamiento y agentes de IA.
Si tu empresa utiliza Cloudflare y quieres asegurarte de que estas configuraciones, WordPress, seguridad y SEO estén trabajando correctamente juntos, en Plataforma Web podemos revisar la configuración técnica de tu sitio y ayudarte a mantenerlo rápido, seguro y visible.
Fuentes:
Cloudflare: Have it both ways — stay discoverable in search while disallowing AI training
Cloudflare: Bot Preference Sync